segunda-feira, 1 de junho de 2015

Neuroevolução


Em posts anteriores vimos que uma rede neural é capaz de responder problemas onde se busca aprender uma resposta que é conhecida. Para isso, a rede é treinada com um algoritmo como o BackPropagation, por exemplo, comparando os resultados esperados com os resultados obtidos e assim fazendo um ajuste incremental. Mas e se a resposta não for conhecida? E se o desafio for descobrir uma forma de resolver um problema? Neste caso, para treinar a rede, ao invés do BP poderíamos usar um algoritmo genético. Algoritmos genéticos também foram discutidos em um post anterior, e neste vimos que eles buscam encontrar uma solução ótima para um problema, criando e aplicando um ambiente de seleção evolutiva. Considerando tudo isso: e se nós usássemos um algoritmo genético para encontrar o conjunto de pesos ideal da rede? É exatamente isso que a neuroevolução faz!

Neuroevolução é um método de aprendizado de máquina que treina redes neurais artificiais através de algoritmos evolutivos, como algoritmos genéticos, e que tem sido muito aplicado em jogos eletrônicos. Algoritmos evolutivos tratam o problema do aprendizado como uma tarefa de otimização, onde podemos definir uma medida de sucesso, chamada  fitness, para ser maximizada ou minimizada, tentando alcançar o melhor resultado possível em um tempo experimental a se determinar. Desta forma, os conjuntos de pesos e símbolos que configuram a população de soluções são representados por genomas, onde cada gene pode representar um peso.

Os genomas passam pelo processo de seleção, cruzamento e mutação por diversas gerações, sendo selecionados pelo seu fitness. O fitness de cada genoma (genótipo) é calculado através da performance de sua rede neural (fenótipos) em resolver o problema proposto (se adaptar) usando os pesos de seu genoma.

A neuroevolução pode ser implementada do modo simples, evoluindo apenas os pesos das conexões, mas também pode ser implementada de forma completa, evoluindo a topologia da rede inteiramente (neurônios e conexões).
Existe um conceituado método de neuroevolução chamado Neuro Evolution of Augmenting Topologies (NEAT). NEAT aumenta o tamanho dos genomas de modo incremental. Quando uma rede neural sofre alguma mutação, esta tende a sobreviver apenas se essa mutação trouxer algum benefício significante para o fitness da rede (genoma do jogador), evitando dessa forma neurônios e conexões inapropriadas que não têm utilidade, assim evitando "trabalho manual" humano em experimentar diferentes topologias. Isso comumente permite encontrar soluções melhores que as dos algoritmos que evoluem somente os pesos.

Através da neuroevolução é possível não apenas resolver os mesmos problemas de antes (onde a resposta era conhecida), como ainda desenvolver controladores inteligentes que aprendem a interagir com um determinado ambiente de forma apropriada.


Abraços miningnoobs!


sábado, 16 de maio de 2015

Algoritmos Genéticos

Um algoritmo genético é um método evolutivo de aprendizado de máquina que se baseia nos princípios da seleção natural observados por Darwin, para descobrir soluções ótimas (ou que tentam se aproximar do ótimo) em problemas diversos.

As soluções (inicialmente aleatórias) são tratadas como uma população de indivíduos (genomas) que lutam para sobreviver e evoluem ao longo de muitas gerações. A solução buscada é tratada como um problema de otimização, onde a cada iteração do processo de evolução, a população de soluções se aproxima da solução ótima.
As soluções geralmente são representadas por um conjunto de variáveis (genes), normalmente um conjunto de números.

A primeira geração é formada por soluções aleatórias. Daí em diante, por N gerações repete-se o seguinte processo:

- cruzamento: as soluções são combinadas de alguma forma representando o processo de reprodução, recebendo assim uma porção das características (valores de variáveis) do pai, e uma outra porção da mãe.
- mutação: os valores das variáveis sofrem uma leve (ou média) perturbação,  simulando o processo de "erro de cópia" genética e assim inserindo diversidade.
- seleção: uma parte das soluções é jogada fora, e a outra é selecionada para "viver" a partir de sua medida de performance (fitness), de modo que quanto maior o fitness, maior probabilidade de uma solução sobreviver, uma vez que significa que se adaptou melhor em cumprir seu objetivo (encontrar a solução ótima).

O fitness é a medida que define o conceito de sucesso da solução buscada. Representa o conceito máximo de sobrevivência, e considerando que a sobrevivência depende de um conjunto de fatores (correlacionados ou não) este deve ser medido por uma equação que leve em consideração todos os fatores de sucesso. Essa equação deve ser definida de acordo com o problema inerente à solução buscada. Por exemplo, se o algoritmo está sendo aplicado em um jogo onde tomar um tiro significa morrer, o fitness deve ser marcado com valor baixo neste tipo de situação onde se morre. No ambiente natural, muitas vezes os fatores determinantes estão associadas à obtenção de alimentos, condições de proteção e capacidade de ataque. Em jogos que simulam ambientes naturais os problemas podem ser os mesmos. Todavia, com a mesma lógica pode-se resolver problemas diversos como problemas de minimização de rotas, redução de custos, ou até mesmo modelagem preditiva (discutido em posts anteriores).

Ao final do processo, o melhor indivíduo (melhor fitness) de todas as gerações é selecionado como solução final, pois é o que mais se aproxima do ótimo, para o problema analisado.


Abraços mining noobs!

sexta-feira, 15 de maio de 2015

Aumentando o poder preditivo de variáveis


 O processo de modelagem vai muito além de aplicar os algoritmos nos dados. Há transformações que podem ser importantes de serem feitas nas variáveis, que vão muito além do âmbito do ETL comum.
Estas transformações às vezes são chamadas de ETL de segundo nível.
Tais transformações são feitas baseando-se em análises estatísticas e ainda em regras de negócio.
No primeiro post, vimos que modelar pode ser comparado com o processo de aprendizado, onde é necessário abstrair características macro dos indivíduos alvo de análise. Esse processo de abstração, pode ser feito, em partes, através da transformação de variáveis antes da seleção de quais vão ou não vão para o modelo.

Quando estamos modelando, pegamos todos os dados que temos disponíveis e testamos (com testes estatísticos) se eles são significantes (discriminantes, correlacionados) para o evento que estamos medindo. Quando uma variável se mostra pouco ou nada importante, nós não mantemos ela no conjunto de dados que será avaliado pelo algoritmo.

O curioso é que: há variáveis que se mostram irrelevantes em sua forma natural, mas após determinados tratamentos (abstrações) podem passar a ser discriminantes.
Isso é importante, pois ajuda a aumentar cada vez mais o poder preditivo do modelo com os recursos (dados) que temos disponíveis (que mutias vezes não são muitos).

Vamos ver alguns exemplos de tratamento que podem aumentar o poder preditivo de uma variável:


Tratamento de missings

Este é um tratamento básico. Imaginemos uma variável que mede o peso de uma pessoa, e consideremos que há uma parte dos indivíduos da nossa amostra com essa variável sem preencher (vazio ou missing). Se essa proporção for pequena, por exemplo, 5%, podemos substituir o valor missing por um valor médio, ou até fazer um outro modelo unicamente para estimar esses valores. É importante pensar se, do ponto de vista do negócio (e quando eu digo negócio, não me refiro só a business, mas à área de conhecimento envolvida) é razoável tratar esse tipo de ocorrência de missing desta forma.
Agora, se o número de casos for muito grande, pode não valer a pena usar a variável, e já descartá-la de cara.
Quanto mais completos os dados estiverem, mais o modelo terá insumos para entender os perfis que se propõe a classificar.


Tratamento de outliers

Outliers são valores fora do comum. Exemplo:  em uma variável que mede a altura de uma pessoa, o valor (em centímetros) 400 seria um outlier.
Esses valores podem ocorrer devido a erros nos dados, ou ainda simplesmente porque realmente existem casos raros. O problema é que mesmo esses casos raros existindo, é complicado para o modelo abrir esse tipo de "exceção". Para facilitar o trabalho, e não confundir o algoritmo, é interessante tratar esses valores com algo como, por exemplo, o valor da média mais o desvio padrão para máximo ou mínimo. desta forma, aquele indivíduo ainda será tratado com a mesma magnitude em termos do valor, mas não será um "desconhecido confuso" para o modelo.


Transformações diversas

Transformações como log de diversas bases, raiz, inverso etc, muitas vezes podem deixar as variáveis "melhores" por tentarem algum tipo de suavização da série de dados (em relação a sua distribuição).


Transformações referentes ao tema

Muitas vezes uma ou até mesmo um conjunto de variáveis não tem muito significado se referente a dados brutos em certas situações inerente ao tema que está sendo tratado. Ex: uma data pode não significar nada, e duas datas tão pouco, sendo três então pior. Porém algum cálculo de distância entre duas delas, sendo maior ou menor do que o dia da terceira data, pode resultar numa variável que tem muito poder explicativo. Isso porque traduz a observação de três eventos que antes não tinham significado, em algo que uma fonte externa já sabe a priori. Ex: em negócios, uma regra de negócio; em medicina, algo sobre o funcionamento do corpo humano.

 Discretização

Alguns algoritmos dependem de que existam relações lineares entre as variáveis explicativas e a variável resposta de um modelo. Entretanto, isso muitas vezes não reflete a realidade, e somente porque uma relação não é linear, não significa que a correlaçõ não existe.
Uma forma de contornar isso é a discretização de variáveis. Neste caso, variáveis contínuas seriam quebradas em categorias. As quebras podem ser feitas usando testes estatísticos que mostram o ponto de corte ótimo, via análise visual ou até mesmo utilizando pontos clássicos como percentis. Ex.: a variável quantitativa idade poderia ser transformada em uma variável categórica com faixas de idade.


Mesclagem

Muitas vezes uma variável  categórica pode ter seu poder preditivo aumentado através da junção de categorias das variável. Isso pode ocorrer porque considerando as categorias individuais não existem padrões, mas juntando algumas, é possível encontrar tendências que antes estavam distribuídas.
Para juntar categorias podemos observar as taxas de casos positivos relativa (odds) e mesclar em uma única categoria as categorias que tiverem taxas similares.


Abraços minning noobs!


segunda-feira, 4 de maio de 2015

Inteligência artificial

No primeiro post, "O que é data mining" vimos que data mining é um processo composto por diversas etapas (onde uma destas é aplicar algoritmos complexos em massas de dados) cuja matéria prima são dados e cujo propósito é criar algum tipo de inteligência que vá interagir com estes dados.


Quando falamos de inteligência, estamos dizendo que o "sujeito" deve ter condições de aprender, ou seja, passar por uma determinada experiência e ser capaz de em próximas situações similares, generalizar as mesmas conclusões (decisões) sobre o desfecho da situação. Se "isso" ocorre com A, e B é bastante parecido com B, logo isso deve ocorrer com B com certa probabilidade razoável.

Dito isso, vamos considerar: o processo de criação de inteligência pode ser feito de diversas formas.

A forma mais elementar e clássica é a estatística. A estatística se preocupa em "medir para poder estimar", sendo uma ferramenta que mede a realidade para perceber nesta padrões e significância, uma vez que aprender (que é o que buscamos) depende justamente de como percebemos  os padrões de comportamento da realidade (quando esses existem). Diversos algoritmos estatísticos são aplicados para resolver problemas de inúmeras áreas do conhecimento a cada ano. Exemplos seriam: regressão logística para diagnosticar doenças ou séries temporais para prever vendas de uma marca etc. Modelos estatísticos estão ligados a testes de hipóteses. Testes de hipóteses tratam de situações do tipo: eu moro num bairro X e saio de casa apenas para comprar pão uma vez por dia às 6 da tarde, e eu tenho a impressão de que vejo mais pessoas de roupa social do que pessoas com roupa esporte...mas será que essa maioria que percebo de fato reflete a realidade? ou será que eu apenas tenho essa percepção porque eu saio de casa em horários de hush onde as pessoas estão voltando do trabalho?  Para evitar este tipo de viés, é importante medir aleatoriamente  parte (ou todos) dos casos, para poder concluir se esta "impressão" tem de fato algum significado.
Porém há outras formas de fazer inteligência. Há muitos algoritmos de aprendizado de máquina que revolvem os mesmos problemas que citamos acima resolvidos pela estatística. Os algoritmos de aprendizado de máquina tentam aplicar algum conjunto de regras que em geral se apoiam em conceitos matemáticos para aprender determinada coisa, seja esta descobrir um padrão, fazer uma previsão, tomar uma decisão etc.

Tudo o que faz o "indivíduo pensante" interagir com algum meio, e com ele perceber algo, é uma forma de inteligência, e isso se parece muito com o processo que faz de nós também algoritmos ambulantes. Embora sejamos como humanidade, o que há de melhor no "mercado de redes neurais", nosso cérebro  enfrenta alguns problemas. As vezes tenta ser tão "espertinho" que na busca por novos padrões, ou na tentativa de economizar energia ele "deduz algumas coisas antes de analisar", como um auto complete que às eventualmente escreve coisas absurdas. O cérebro também quer economizar recursos e pegar atalhos, e no final das contas, ficamos sujeitos a muita subjetividade. Porém, quando aplicamos os mesmos conceitos num ambiente onde o erro é medido e controlado, resolvemos problemas que humanos não conseguem em geral com tanta assertividade. E isso tende a se estender para todos os tipos de conteúdos a serem processados, ou seja, todos os tipos de interações existentes atualmente. O que se faz com IA hoje ainda engatinha, mas não há porque pensar que existe qualquer tipo de "limite" pra isso, uma vez que o conceito de aprender em si está provado artificialmente. Por que seria possível aprender alguns padrões e outros não? Se é possível hoje, muito facilmente, um algoritmo aprender a identificar a emoção contida numa expressão facial, por que seria absurdo pensar que este mesmo algoritmo incrementadíssimo pudesse aprender o "inteligência" do processo neural que é o amor? Essa ilusão de que há "um QUE de especial na humanidade" só tende a cair cada vez mais por terra, a cada pesquisa que é publicada na comunidade de IA e áreas correlatas. Até que se prove o contrário,  tudo que pensamos, lembramos e sentimos se resume a um conjunto complexo de conexões neurais, elementos químicos sendo estimulados por impulsos elétricos.

Opiniões à parte, a comunidade acadêmica têm feito sua cria à sua imagem e semelhança (pois nada faria mais sentido que isso a princípio!). Um dos modelos mais famosos de inteligência artificial são as Redes Neurais Artificiais (sobre as quais falamos em um post anterior). E estas, nada mais são do que um modelo matemático bastante simplificado referente ao que se conhece atualmente sobre a dinâmica de funcionamento do cérebro. Basicamente tenta-se simular o processo das sinapses, representando os neurônios e suas conexões como um grafo orientado onde os vértices são os neurônios e as arestas são as ligações entre eles, que permitem a sinapse cuja força se define pelo peso da aresta. Modelos de redes neurais são incríveis, pois são capazes de prever tanto variareis quantitativas quanto qualitativas, e ainda ter N saídas  (N decisões a tomar) sendo analisadas simultaneamente.

Há ainda outras formas de inspiração que vem sendo aplicadas, como  a bio inspiração, onde baseado em comportamentos da natureza, podemos abstrair um processo inteligente. Exemplos: o organização das formigas, dos pássaros, e até fungos!
Dentre os algoritmos bio inspirados estão os Algoritmos Genéticos, que se baseiam nas observações evolucionistas de Darwin, onde soluções (indivíduos compostos por um conjunto de valores numéricos que representam genes de um DNA) "lutam" pra sobreviver, onde a medida de sucesso é realizar uma determinada tarefa, como prever por exemplo, onde essa tarefa é decidida por esse conjunto de valores (DNA).
Desta forma, diversos artigos mostram empiricamente que a teoria da evolução de sustenta, em termos de método pelo menos. Ou seja, é possível do aleatório convergir para o sucesso, seja lá o que o sucesso for, somente pela seleção natural (ou artificial =D). O que importa é haver um ambiente de competição, onde há morte e reprodução. Onde houver morte e reprodução... comprtição haverá inteligência, mesmo que esta seja uma inteligência "codificada na  composição" do indivíduo.

Ironias à parte, é importante termos em mente que não importa se estamos usando estatística, aprendizado de máquina ou qualquer coisa, o que importa é que data mining usa diversas ferramentas com o objetivo de criar algum tipo de inteligência (artificial) a partir dos dados, para interagir com estes de alguma forma que faça sentido, obtendo assim algum conhecimento.


Abraços miningnoobs!


segunda-feira, 21 de julho de 2014

Redes neurais artificiais


No post Tipos clássicos de modelos, comentamos sobre alguns tipos como: Modelo de propensão e Modelo de estimação.
Sendo o primeiro para classificar indivíduos/itens em categorias, atribuindo uma probabilidade para essa classificação; e o segundo para estimar um valor quantitativo de algo para o indivíduo/item.

Exemplos de modelo de propensão: classificar uma pessoa como portadora ou não de uma determinada doença; classificar uma pessoa como possível não pagadora de seu aluguel; classificar uma foto de um rosto em relação ao sentimento que o rosto expressa.

Exemplos de modelo de estimação: estimar a taxa de glicose de uma pessoa; estimar o valor de um imóvel; estimar o gasto de um cartão de crédito.

"Redes neurais artificiais" é um modelo computacional de aprendizado de máquina que pode ser usado tanto como modelo de propensão (para múltiplas categorias), quanto para modelo de estimação (fora outras inúmeras aplicações para criação de inteligência).

Uma rede neural tenta simular o processo de aprendizado feito pelo cérebro, que é formado por bilhões de células especiais, chamadas neurônios. A forma como esses neurônios se conectam entre si, caracteriza o pensamento e a memória, e o aprendizado é feito a través dessas conexões.
Como o processo de modelagem nada mais é do que aprender através de  uma massa de dados, a ideia da rede neural artificial é simular essa dinâmica para chegar no mesmo tipo aprendizado.

A estrutura topológica clássica das Redes neurais artificias é a Multilayer Perceptron. Esse modelo de rede neural é representado por: entradas que representam as variáveis explicativas, neurônios de camadas intermediárias a fim de reproduzir níveis de relação complexos e a camada de neurônios de saída (que representa a variável resposta).
Essa rede pode ser treinada de várias formas, e o método mais comum é treiná-la através do algoritmo Backpropagation.
Neste, pesos aleatórios são inicialmente atribuídos a cada conexão entre neurônios (variáveis de entrada vs neurônios auxiliares intermediários e neurônios auxiliares intermediários vs variáveis de saída).

A partir dos pesos aleatórios, calculam-se multiplicações e somatórias, de moto que no final, tenha-se um valor próximo ou não de 1 para cada variável de saída. Esse valor, para cada indivíduo/item do conjunto de treinamento é comparado com o valor real. Quanto mais distante estes estiverem (real vs previsto), mais os pesos são ajustados.
Esse processo é feito de forma iterativa até que a diferença média entre o real e o previsto seja razoável.

Redes neurais é um ótimo método de aprendizado de máquina, e que tem sido aplicado a diversas áreas do conhecimento apresentando grande performance.

A desvantagem dele é que, quando há necessidade de interpretar os resultados (motivos) de uma determinada classificação, ele não atende. Isso porque a estrutura de ligações entre neurônios (variáveis) citada anteriormente, é muito complexa  e "fechada" e não permite esse tipo de interpretação.

O que mais importa em um modelo de previsão, é o fato de ele prever com assertividade, mas há situações onde se deseja entender as relações entre as variáveis. Desta forma, tudo pode depender da finalidade da aplicação.


Abraços miningnoobs!


Ferramentas de Data Mining


Há muitas ferramentas que permitem fazer Data Mining por aí, incluindo ferramentas livres e proprietárias.

Eventualmente pode surgir a pergunta: qual delas é a melhor? E ainda: o que vale mais a pena...ferramenta livre ou proprietária?

Certamente as respostas para essas perguntas são bem relativas. Vai depender muito da natureza do projeto para o qual você utilizará a ferramenta, assim como o seu perfil como usuário.
Se você é do tipo que gosta mais de programar as coisas "manualmente" algumas ferramentas podem ser mais adequadas que outras, que fornecem apenas programacão visual.
Algumas são mais encapsuladas, não permitindo que você veja ou configure certos detalhes e parâmetros, mas outras são mais completas e totalmente abertas, pois são para usuários mais avançados.

Em relação a software livre, não se preocupe, pois há ferramentas de data mining livre que são tão boas quanto ou ainda melhores que algumas proprietárias.

Para usuários pessoa física, em geral vale mais a pena ficar com o software livre mesmo. As comunidades das ferramentas costumam ser bem fortes, há documentação oficial, e ainda sempre tem fóruns diversos de perguntas e respostas. É muito fácil achar a resposta pra sua pergunta, a ainda ver exemplos prontos daquilo que você quer fazer.

Já para empresas, às vezes é mais seguro comprar um software proprietário. Isso por causa do suporte oferecido pela desenvolvedora após a compra. Uma empresa não pode contar com a dúvida do: "talvez eu ache a solução disso na internet (mesmo sendo bem provável que ache mesmo)", pois há dinheiro e clientes envolvidos. Então, é necessário ter uma outra empresa de quem você possa cobrar uma solucão.
Por outro lado, a quantidade de materiais e informação disponível na internet para essas ferramentas já não é tão grande, afinal, pelo software ser proprietário, o público fica mais restrito.


Algumas ferramentas livres:


Python: linguagem de programação usada para diversas finalidades. Dentre suas inúmeras bibliotecas estão: Scikit Learn - com vários algoritmos de aprendizado de máquina e estatística, assim como outras funcionalidades para modelagem; Scipy - com várias funcionalidades matemáticas e estatísticas. Além dessas bibliotecas específicas, o Python tem várias funcionalidades que podem ser usadas para tratar os dados no processo de modelagem.

R: linguagem de programação para matemática e estatística. Possivelmente uma das mais completas, contando com muitíssimas bibliotecas. Permite também tratamento de dados.


Algumas ferramentas proprietárias:


SPSS Statistics: ferramenta com diversos algoritmos, testes estatísticos, gráficos de análise, tratamento de dados etc. Possui uma linguagem de programação própria, mas todas as funcionalidades podem ser aplicadas através de menus.

SPSS Modeler: ferramenta com diversos algoritmos, gráficos de análise, tratamento de dados etc. Funciona com programação visual, onde você clica e arrasta em nós que representam funcionalidades, conectando-os entre si, de modo a formar um fluxo de funcionalidades. Possui ainda uma série de automatizações, tanto na parte de tratamento de dados como na parte de aplicacão de algoritmos.

SAS: ferramenta com diversos algoritmos, testes estatístios, gráficos de análise, tratamento de dados etc. Possui uma linguagem de programacão própria, mas todas as funcionalidades podem ser aplicadas através de menus.


Há ainda outras ferramentas como MatLab, Estatística, K-nime, Weka etc.


Abraços miningnoobs!

sexta-feira, 20 de junho de 2014

Tutorial – criando um jogo de plataforma demo com Pygame e Tiled

Desviando só um pouquinho do tema deste blog, gostaria de compartilhar este tutorial que montei.

1 - Introdução
Pygame é uma biblioteca da linguagem Python para desenvolvimento de games.
O download desta pode ser feito em: http://www.pygame.org/download.shtml
Neste tutorial, vamos utilizá-la para criar um jogo de plataforma básico (demo).
Além disso, vamos utilizar para a criação do mapa da tela, o software Tiled, e uma lib para manipular o arquivo do mapa criado por este.
O download do Tiled pode ser feito em: http://www.mapeditor.org
O arquivo do mapa gerado pelo Tiled, é um xml com uma extensão chamada tmx.
Existem algumas bibliotecas que foram criadas para manipular este tipo arquivo, e neste caso, escolhemos trabalhar com a biblioteca do Richard Jones. Para isso podemos baixar o arquivo tmx.py do link: https://github.com/renfredxh/tmx
  • Baixe e instale o Pygame e o Tiled. Após isto, crie um diretório chamado “demo“ e coloque dentro dele o arquivo tmx.py.
2 – Criação do mapa da tela
  • Abra a linha de comando do Linux e digite tiled para abrir o Tiled. Crie um novo arquivo e salve-o no diretório “demo”.
O Tiled possui dois tipos de camadas:
Camadas de tiles
Onde é desenhado o cenário do mapa através de imagens.
Por padrão, o mapa já virá com uma camada de tiles criada. Para adicionar imagens nesta camada, clique no menu Mapa > Novo Tileset e selecione a imagem desejada. Isso deve ser feito para cada imagem.
As imagens carregadas ficarão disponíveis na lista de tilesets à direita da tela. Ao clicar em uma imagem após carregada, você vai perceber que se passar o mouse em cima do mapa, ela estará disponível para ser carimbada nele conforme seus cliques. Além disso, você não precisa carimbar a imagem inteira. Você pode escolher quais tiles (pedacinhos) da imagem você quer selecionar.
  • Carregue as imagens desejadas e desenhe todo o mapa da tela do seu jogo.

Camada de objetos
Onde são adicionados os objetos que ocupam espaço físico ou representam triggers no mapa. Esta camada normalmente deve ficar invisível (para isso, basta desmarcar o checkbox dela).

  •  Para criar uma camada de objetos, clique no menu Camada > Adicionar camada de objetos, e renomeie a camada criada como “triggers”.
A camada de objetos é onde você define paredes, chão, teto, plataformas, indivíduos, itens etc.
Se você quer criar, por exemplo, uma parede lateral, você deve desenhá-la na camada de tiles, e na camada de abjetos adicionar um retângulo sobre ela.
Ou seja, o desenho em si não representará nada para o pygame a não ser uma imagem a ser renderizada, de modo que somente os objetos (alinhados com a imagem) poderão interagir com o código.
Os objetos dessa camada serão enxergados e manipulados pela biblioteca tmx.
  • Através do botão Inserir Objeto (O) no menu principal do topo, crie os objetos retangulares desejados que representem as paredes, teto, chão e plataformas do seu jogo. Clique com o botão direito em cada objeto, selecione Propriedades do objeto e insira uma nova propriedade com nome “blockers” e valor “tlrb”.
    Além dos objetos retangulares, você pode inserir ainda objetos carregados a partir de imagens externas. Isso serve para representar os personagens e itens da tela.
Todavia, não vamos carregar ainda a imagem diretamente no mapa. Vamos carregar uma imagem auxiliar onde cada quadradinho da imagem seja aproximadamente do tamanho de um tile (32x32 px).
Ex.:

Esses quadradinhos, de quantidade a definir, devem representar cada tipo de item, personagem ou trigger da tela.
  • Crie uma imagem auxiliar que represente os itens do seu jogo em um editor qualquer e clique em Mapa > Novo Tileset para adicioná-la.
  • Clique com o botão direito em cada tile do tileset e adicione uma propriedade que nomeie o item representado por cada tile. Ex.: nome “player” e value “yes”.
  • Clique na flechinha rosa abaixo da caixa de tilesets e exporte esse tileset para o diretório “demo” como .tsx.
  • Através do botão Inserir Tile (T) no menu principal do topo, coloque no mapa os objetos auxiliares desejados que representem indivíduos, itens ou triggers do seu jogo.

3 - Codificação
  • Importe as bibliotecas pygame e tmx.
  • Inicialize o pygame e o joystick:
pygame.init()
pygame.joystick.init()
  • Crie o objeto que representa a tela (passando como parâmetro o tamanho desta):    screen =   pygame.display.set_mode((768, 576))                             
  •  Defina um temporizador Para atualizar os frames da imagem a ser renderizada:    clock = pygame.time.Clock()
  •  Carregue o mapa criado no Tiled:
           tilemap = tmx.load('map.tmx', screen.get_size())

Sprites são a representação de indivíduos, itens etc no jogo, e devem ser criados para manipular os mesmos.
Ex.1 – criação de um sprite que representa o jogador (como este é apenas um único, deve-se escolher o índice 0 do array):
sprites = tmx.SpriteLayer()
start_cell = tilemap.layers['triggers'].find('player')[0]
player = Player((start_cell.px, start_cell.py), sprites)
tilemap.layers.append(sprites)
Ex.2 – criação do grupo de sprites de inimigos (como são vários, é necessário inserir em um loop) :
enemies = tmx.SpriteLayer()
for enemy in self.tilemap.layers['triggers'].find('enemy'):
    Enemy1((enemy.px, enemy.py), enemies)
tilemap.layers.append(enemies)
Podemos notar que: o nome “triggers” que é citado agora, é o mesmo que foi designado no mapa do Tiled para a camada de objetos; o nome passado como parâmetro para a função find, também foi designado no mapa do Tiled como propriedade de cada tile representando um item ou indivíduo; a função find retorna a posição do item no mapa em relação aos eixos x e y;
  • Crie grupos de sprites para todos os indivíduos e itens do seu jogo na tela do mapa criado. Ex.: player, enemies, bullets, guns, lifes etc.
O jogo precisa ter um loop principal que manterá o jogo rodando e sendo atualizado.
Neste loop, você deve:
- limitar os frames a serem atualizados por segundo: dt = clock.tick(30)
- capturar os eventos gerados no pygame com o sub loop:
                for event in pygame.event.get():
                    # fecha o jogo caso haja clique no “x” da janela
                    if event.type == pygame.QUIT:
                        return
           - preencher a tela com uma cor solida, de modo a evitar blurring dos itens renderizados:     
               screen.fill((250,250,250))
- atualizar o objeto do mapa conforme frames: tilemap.update(dt / 1000., self)
- desenhar os itens do objeto do mapa na tela: tilemap.draw(screen)
- atualizar a tela: pygame.display.flip()
- verificar a life do player de modo a tomar a ação adequada caso a life tenha acabado (como por exemplo sair do jogo ou apresentar uma mensagem de game over).
  • Crie um loop principal para o seu jogo.
Para todos os sprites criados anteriormente, é necessário ter uma classe com as definições dos mesmos.
O objeto tilemap deverá manipular os objetos das classes de cada sprite automaticamente, a partir de algumas funções e atributos padrão.

Ex.1 – Classe de indivíduos/itens

  • Crie a classe do sprite desejado passando a classe sprite como parâmetro: (pygame.sprite.Sprite).
  • Carregue a imagem do indivíduo/item no atributo image: image = pygame.image.load('...')
A função principal da classe deve ter o seguinte formato básico:
def __init__(self, location, *groups):
    super(NOME, self).__init__(*groups)
O parâmetro “location” se refere à posição inicial do indivíduo/item e o parâmetro “*groups” faz referência ao objeto de sprites localizado na chamada da classe.
A posição do indivíduo deve ser marcada no atributo “rect”.
Para inicializar o atributo de localização do indivíduo/item use:
self.rect = pygame.rect.Rect(location, self.image.get_size())
É necessário ter uma função chamada “update” para atualizar os objetos da classe:
def update(self, dt, game):
  •  Programe o incremento ou decremento do atributo “rect” para mover o indivíduo/item na horizontal, ex.: self.rect.x += 100 * dt
Neste caso o número 100 é o salto e dt é a ponderação pela velocidade de atualização de frames, configurada anteriormente.
  •  Verifique uma possível colisão do objeto atual com outros objetos da seguinte forma:
              for cell in game.tilemap.layers['triggers'].collide(self.rect, 'reverse'):
                  # aqui vão as ações cabíveis em caso de colisão.
No exemplo acima, estamos verificando a colisão do objeto atual com objetos do tipo 'reverse'. Lembrando que esses tipos são definidos nas propriedades do mapa criado no Tiled.
  •  Verifique se o objeto atual colidiu com o player:
              if self.rect.colliderect(game.player.rect):
                  # aqui vão as ações cabíveis em caso de colisão.

Ex.2 – Classe do player
A classe do player deve conter quase as mesmas coisas que a classe do exemplo anterior, pois ele também é um indivíduo/item.
Todavia, haverá provavelmente um conjunto maior de ações e verificações a serem feitas.
Exemplos:
Em descanso: self.resting = False
Velocidade: self.dy = 0
Marcação da life do player.
Leitura do joystick e teclado:
joystick = pygame.joystick.Joystick(0)
joystick.init()
key = pygame.key.get_pressed()
# anda para frente
if key[pygame.K_LEFT] or joystick.get_axis(0)<0:
    self.rect.x -= 300 * dt
# anda para trás
if key[pygame.K_RIGHT] or joystick.get_axis(0)>0:
    self.rect.x += 300 * dt
# pulo e queda
if self.resting and ( key[pygame.K_SPACE] or int(joystick.get_button(2)) == 1) :
    self.dy = -500
    self.dy = min(400, self.dy + 40)
    self.rect.y += self.dy * dt
Verificação de colisão com “blockers” (chão, parede ou plataformas):
new = self.rect
self.resting = False
for cell in game.tilemap.layers['triggers'].collide(new, 'blockers'):
    blockers = cell['blockers']
    # limite à direita
    if 'l' in blockers and last.right <= cell.left and new.right > cell.left:
        new.right = cell.left
    # limite à esquerda
    if 'r' in blockers and last.left >= cell.right and new.left < cell.right:
        new.left = cell.right
    # limite do chão
    if 't' in blockers and last.bottom <= cell.top and new.bottom > cell.top:
        self.resting = True
        new.bottom = cell.top
        self.dy = 0
    # limite do teto
    if 'b' in blockers and last.top >= cell.bottom and new.top < cell.bottom:
        new.top = cell.bottom
        self.dy = 0

É importante forçar que a janela mantenha o foco no player como item central: game.tilemap.set_focus(new.x, new.y)
  • Crie as classes dos indivíduos e itens do seu jogo.

Um vídeo tutorial de Richard Jones (mais detalhado, porém em inglês) está disponível no link: http://pyvideo.org/video/2620/introduction-to-game-programming

Abraços miningnoobs !

quinta-feira, 5 de junho de 2014

Validação de modelos


Conforme já mencionamos em outro post, uma das etapas mais importantes no processo de desenvolvimento de um modelo é sua validação.
Isso porque não adianta você criar um modelo, e partir do pressuposto de que ele funciona. É preciso verificar e provar tal pressuposto, de forma a validá-lo.

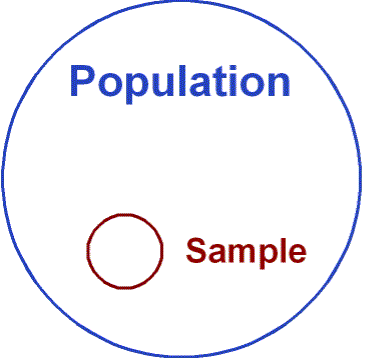
Já comentamos, também em outro post, que no processo de modelagem, provavelmente vamos extrair uma amostra de dados da população total.
Essa amostra, entretanto, não deverá ser utilizada inteiramente para fomentar o aprendizado do modelo. Isso porque uma parte desta deverá ser reservada para a etapa de validação, ou teste.

O motivo disso é simples. É fácil dizer que o modelo acerta suas previsões e classificações para os mesmos indivíduos que fizeram parte do processo de aprendizado. Afinal de contas, o modelo já conhece esses indivíduos. Entretanto, na prática da "vida real do modelo", ele será utilizado para prever e classificar indivíduos que ele desconhece. Esse é o verdadeiro desafio, e portanto, é isso que deve ser medido na validação.

Pra tal, precisamos reservar uma parcela da nossa amostra, que não tenha nenhuma participação no processo de desenvolvimento do modelo, e que, apenas no final seja utilizada para colocá-lo à prova.
O acerto nesta amostra de indivíduos (amostra de validação ou teste), poderá ser considerado o acerto previsto final esperado na prática.

O tamanho da amostra de validação pode variar dependendo do caso, mas algo em terno de 30% da amostra total é bastante razoável.

É bom ressaltar que neste caso estamos falando de aprendizado supervisionado. E é justamente neste momento de validar, que estamos supervisionando nosso aprendizado.


Por exemplo:


Imaginemos que nosso público alvo são homens acima de 50 anos em São paulo, e que conseguimos coletar uma amostra de 100.000 indivíduos.
Vamos reservar 30% destes para validação (amostra de validação), sendo 30.000 indivíduos, e os outros 70% (70.000 indivíduos) serão utilizados na aprendizagem (amostra de desenvolvimento) do modelo. É importante que essa separação de indivíduos seja aleatória.

Agora vamos imaginar que criamos um modelo de propensão para uma resposta binária (como infarto sim/não) com a amostra de desenvolvimento, e aplicamos o modelo na amostra de validação para testar seu acerto.
Nesse exemplo hipotético, digamos que nosso acerto tenha sido de 75%.
Isso significa que quando estivermos usando o modelo na sua aplicação prática, ele tenderá a acertar em  aproximadamente 75% de suas previsões. Essa é a capacidade de generalização dele.

Um ponto importante de comentar é que, um modelo não pretende acertar todos os casos, pois dificilmente isso é viável. Um modelo se propõe a acertar uma quantidade razoável, que seja melhor do que uma escolha aleatória, portanto este deve fornecer uma medida para sua expectativa de acerto. Devemos ter em mente que em meio a muitos acertos, sempre haverão erros, mas isso ainda será melhor do que tomar uma decisão de forma arbitrária.

Quando temos uma amostra pequena, ou simplesmente quando queremos apenas garantir um resultado mais estável, podemos usar técnicas de validação que repetem esse processo de separação de amostras várias vezes para garantir expectativas de acerto mais seguras, como K-Folds,  mas isso já é outro assunto.

Acertos nas categorias


Cuidado! Vamos agora imaginar que na amostra do nosso público alvo, apenas 10% dos indivíduos tiveram infarto no período do estudo, e os outros 90% não.
Se nosso modelo simplesmente atribuir uma previsão negativa para todos os indivíduos, ele acertará 90%. Esse número parece muito bom olhando o acerto total, mas na prática, sabemos que o modelo é inútil, pois não acerta nenhum caso onde o indivíduo é positivo.
Deviso a isso, não podemos olhar apenas o acerto total. Precisamos avaliar o acerto de todas as categorias, para garantir que mesmo em amostras desbalanceadas, o acerto será razoável para todas as categorias de resposta.
Dessa forma, poderemos dizer que nosso modelo é capaz de discriminar entre as estas (neste caso, infarto sim/não).


Abraços miningnoobs!


quinta-feira, 29 de maio de 2014

Big Data ?! A nova buzzword.

E falando em moda, está aí a buzzword do momento: Big Data! Peraí...mas quem falou em moda?...rs...Anyway...

Todo mundo agora quer saber de Big Data. Comprar Big Data e vender Big Data...!
Mas quem sabe de fato o que é Big Data (BD)? Muitos não sabem, mas acham que sim.

Muita gente pensa que só porque tem uma base de 1 milhão de clientes, isso é BD. Se você tem uma base de dados bem grande e estruturada, sobre a qual você conhece a estrutura e conteúdo, isso não é BD. Você poderia ter 54859345843 trilhões de clientes na base, ou um "googleplex" de registros de transações bancárias e isso ainda não seria BD. Isso seria apenas um "montão de dados". =)

Pra ser  BD, há alguns critérios a se considerar, como: a maior parte do que está entre esses dados ser lixo! Mas entre o lixo, há coisas úteis a serem descobertas. É um mar de inutilidades a ser percorrido para achar um tesouro perdido. Outra coisa é que normalmente os dados estão desestruturados. Mesmo que estejam em um banco de dados, o conteúdo pode ser texto, e dentro daquele texto podem haver várias informações diferentes que você não sabe onde começa uma ou termina a outra.

O exemplo mais claro disso são as redes sociais. As informações estão armazenadas em um banco de dados especial, mas os conteúdos são diversos. Num único post você pode ter várias informações sobre uma pessoa. E como você vai descobrir qual parte é qual, e o que é útil?

Na prática, você vai precisar que ter uma boa infra estrutura pra guardar tudo isso e analisar.

Agora...é claro que você não vai analisar manualmente, caso a caso...rsrs...e mesmo se isso fosse feito, dificilmente perceberia algo de genial.

É ai que entram os algoritmos de mineração de dados pra te ajudar a descobrir padrões no BD, e fazer dele algo útil e palpável. Eles possibilitam enxergar algo que antes era invisível.

Os dados que levam a grandes descobertas sobre os padrões de funcionamento do mundo podem estar nos lugares mais inóspitos... ^^...então temos que fuçar!


Abraços miningnoobs!


Público alvo, amostra e período

Nos posts anteriores vimos que para fazer um modelo, precisamos definir antes: qual a pergunta que queremos responder. Ex.: quais as chances de alguém ter um infarto?

Após isto, há mais uma pergunta básica que deve ser feita: de quem ou o que estamos falando? Ou seja, qual o público alvo?

Precisamos definir quais as características dos indivíduos/coisas que vamos analisar.
Por exemplo, podemos definir que nosso público alvo para a pergunta acima é composto por:  mulheres, viúvas, que moram na região central de sp e fumam.
Desta forma, os dados coletados para o estudo devem ser somente de indivíduos que estejam dentro destas características.
É importante ter em mente que o modelo que será criado, deverá ser (idealmente) aplicado a indivíduos do mesmo público. Ou seja, não seria coerente aplicar o modelo em homens, ou ainda em mulheres que não fumam. Isso porque estes não fizeram parte do conjunto de mapeamento do estudo. Eles não participaram da modelagem, de modo que corre-se o risco (não necessariamente, mas não da pra saber a priori) de eles não apresentarem um comportamento similar aos outros.
Isso não significa que vamos aplicar o modelo somente nas pessoas que participaram da modelagem. Afinal de contas, dessa forma o modelo não serviria de nada. Quero dizer que vamos aplicar em outras pessoas, mas sendo estas, pessoas que fazem parte do mesmo perfil definido no público alvo.
É muito importante que fique bem claro logo no começo qual a definição exata desse público alvo, de modo a evitar retrabalhos futuros.

Após definir o público, precisamos avaliar a volumetria de dados que temos disponível, considerando a resposta que foi definida.
Devemos lembrar que podem haver diversas restrições quanto à quantidade de dados a ser considerada no estudo. Não somente por questões de processamento e armazenamento (afinal hoje em dia isso já não é um problema tão grande), mas por questões de viabilidade de coleta também.
Muitas vezes os dados do estudo não estão disponíveis em um sistema, e é necessário coletá-los. Por exemplo: com pesquisa de campo ou em redes sociais.
Dessa forma, é pertinente definir uma amostra a ser coletada da população.
O tamanho ideal da amostra é uma questão um pouco subjetiva. Há alguns cálculos estatísticos que permitem definir o tamanho ideal, mas nem sempre isso é necessário, pois vai depender muito da situação. Não existem números mágicos, mas a partir de 1.000 casos já temos alguma coisa razoável.
Um fator que deve ser considerado com muita cautela é a questão da aleatoriedade.
A amostra deve ser aleatória! A menos que se esteja usando alguma técnica de estratificação ou algo assim, mas isso deve ser feito com cuidado e exige conhecimentos adicionais.
Isso serve para evitar criar vieses na amostra.
Ex.: imagine que você extraia os dados de cadastro de clientes de um sistema transacional pegando os primeiros 10.000 da tabela. Imagine agora que a base estava ordenada por idade. Desta forma o seu modelo terá mais gente nova do que velha para ser modelada (isso se não acabar entrando só gente nova). O problema é que na prática você aplicará o modelo tanto em gente velha quanto em gente nova, mas o seu modelo não conhece o comportamento das pessoas mais velhas. Desta forma, ele tende a errar nas previsões destes indivíduos.

Por último, precisamos ainda definir um período histórico para nossos dados.
Devemos pensar na dinâmica do assunto que estamos tratando em relação ao tempo.
Por exemplo, se estivermos falando do mundo de finanças, devemos pensar que dados muito antigos talvez não reflitam a economia atual, uma vez que esta pode mudar tão rápido.
Entretanto, não podemos também pegar somente dados de ontem, pois é cedo de mais para perceber um padrão! Devemos avaliar bem o histórico que vamos utilizar, até porque isso impacta na volumetria. É preciso ponderar o custo/benefício de um histórico mais longo, e ainda o malefício (por pegar dados que já não refletem a realidade).


Abraços miningnoobs!


segunda-feira, 21 de abril de 2014

A importância dos dados

Até agora temos falado das técnicas para analisar dados e extrair padrões destes. Mas além das técnicas, existe um detalhe muito importante, que deixa até de ser detalhe.
Tão importante quanto as técnicas a serem aplicadas aos dados, são os próprios dados.
Não há modelo ou algoritmo que "salve" dados ruins. Mas o quero dizer com 'dados ruins'? 'Dados ruins' não é uma expressão que se refere a dados que não apresentam o resultado que queremos, mas sim a dados que não representam a realidade como ela é.

Modelos são abstrações da realidade. Isso significa buscar identificar as características macro que definem o alvo analisado através de um conjunto de dados capaz de representar essa realidade. Logo, se o conjunto de dados apresentado for distorcido, a representação que o modelo fará será distorcida, de modo que em relação ao que se deseja analisar de fato, o modelo não terá valor ou significado algum.

Devido a isso, a etapa de entendimento dos dados se mostra como uma etapa bastante decisiva. As conclusões após essa etapa podem levar a desistir de criar um modelo, devido à possível inexistência de dados confiáveis, fidedignos. Isso porque, um modelo feito em dados distorcidos, vai apenas prejudicar o processo de decisão e descoberta, uma vez que levará a conclusões errôneas ou à descoberta de padrões irreais, que não terão efeito no mundo prático. Modelos feitos em dados não íntegros levam-nos a vieses e ao erro.

Vamos ver alguns pontos que valem a pena serem ressaltados a esse respeito:

Metadados

O básico na etapa de entendimento seria verificar se há um metadados disponível para ajudar a entender os dados. Entretanto, sabemos que muitas vezes este não existe, e acabamos tendo que fazer uma investigação mais longa, através de conversas com diversas pessoas envolvidas no processo de geração dos dados, ou analisando documentos que possam conter essas definições. Seja como for, é essencial garantir que não estamos interpretando os dados de forma incorreta, como por exemplo, considerar o campo de 'valor de parcela' como campo de 'valor não pago de parcela'.

Governança de dados

Algo que deve ser questionado é: o quanto podemos confiar no processo que gera os dados? Por exemplo, imagine que você está fazendo um modelo e um dos dados disponíveis é o 'salário'. Será que existe um processo de verificação do salário informado pelo cliente, ou o que é inserido no banco é apenas o que o cliente informa verbalmente? Caso não haja uma verificação, devemos pensar duas vezes antes de considerar esse dado no modelo.

Outros

Alguns campos dificilmente podem ser considerados, dado que a informação é inserida no cadastro manualmente. Um exemplo disso seria o campo 'profissão'. Muitas vezes num processo de cadastro, um atendente não entende ou não encontra a profissão informada pelo cliente e seleciona uma profissão que ele acredita ser similar. Além disso, ele pode definir a profissão como 'outros'. Desta forma duas coisas podem acontecer: pessoas serão classificadas em profissões inadequadas; o campo profissão terá uma grande porcentagem de pessoas em outros, e não será muito informativo.


Abraços miningnoobs!


sexta-feira, 7 de março de 2014

Correlação vs Causalidade

Conforme vimos anteriormente, para fazer previsões sobre um determinado evento é necessário usar um conjunto de variáveis (informações).
Hoje vamos entender como essas variáveis se relacionam e como é possível que elas de fato ajudem nessas previsões.
Pra isso precisamos entender o conceito de correlação. Podemos dizer que duas variáveis estão correlacionadas quando é possível observar que as ocorrências de algum valor de uma delas acontecem com uma frequência parecida com o valor da outra. What ??!!!

Exemplo: em relação a uma determinada pessoa, a variável "gastos mensais" pode aumentar conforme a variável "salário" aumenta. Isso porque normalmente quando se ganha mais gasta-se mais. Então estes eventos estão correlacionados. Neste caso, além de correlação existe ainda a presença da causalidade. Isso porque o motivo de estar se gastando mais é justamente por se ganhar mais.

Neste caso temos correlação e ainda causalidade. Mas existem casos onde temos apenas correlação, sem causalidade.

Um exemplo disso seria:

Imagine uma praia onde conforme aumenta o "número de picolés vendidos" aumenta também o "número de afogamentos". Vamos proibir a venda de picolés, porque pessoas estão morrendo afogadas ?!...claro que não.
Neste caso, existe correlação, porque essas duas variáveis ("número de afogamentos" e "número de picolés") tem frequências de ocorrências similares. Entretanto, não é uma que está causando a outra.
Então porque suas frequências são similares? Bom, normalmente isso ocorre porque existe uma terceira variável por de trás disso causando as duas coisas.
Neste caso, a variável é a "temperatura". Em dias quentes, mais pessoas tomam sorvete, e também mais pessoas entram na água para nadar, aumentando assim a chance de se afogarem.

E como essa informação pode ser útil? Bem, o interessante disso, é que mesmo quando não existe causalidade  (o que ocorre na maioria das vezes) , a variável ainda sera útil para explicar e prever o evento da variável que queremos.
No exemplo acima, mesmo que os afogamentos não causem a venda de picolés ou vice versa, bastaria colocar uma barraquinha de sorvete em praias com um grande número de afogamentos, que as vendas de picolés aumentariam. =)

No processo de modelagem é isso o que ocorre. Olhamos os dados e variáveis disponíveis, e tentamos descobrir quais delas estão correlacionas com o evento que queremos prever (evento final).
No final, não importará se elas são ou não as causadoras do evento final. O que importa é que através delas é possível prever este evento, e isso é tudo que nos interessa.

Por exemplo na área da medicina:

Se um modelo foi criado dizendo que pessoas "com mais de 70 anos, que moram no interior, de sexo feminino, da classe C e sem filhos" tem 95% de chance de ter uma determinada doença, não importa se essa tendência de ter a doença é devida às características citadas, o que importa mesmo é que temos um diagnóstico, e pessoas com esse perfil devem se tratar, pois existe algum fator implícito expresso por de trás dessas características que causa a doença.


Abraços miningnoobs!


quinta-feira, 23 de janeiro de 2014

Tipos clássicos de modelos

Conforme vimos no último post, existem diferentes tipos de aprendizagem e diferentes tipos de variáveis a serem analisadas.

Agora veremos os tipos mais clássicos de modelagem. Ou seja, os formatos de perguntas mais comuns no mundo da modelagem.


Modelos de Propensão


São modelos que buscam predizer uma variável categórica, seja binária ou de múltiplas categorias. É um aprendizado supervisionado.

Exemplos:

binária - classificar uma pessoa como portadora de uma doença: sim/não
múltiplas categorias - classificar um carro como sendo da categoria: A/B/C/D

Modelos assim predizem a qual categoria um indivíduo/objeto pertence, e qual a probabilidade disso ser verdade.

Ex.1:  dadas suas características, João foi classificado pelo modelo como tendo 76% de chance (propensão) de estar doente (sim).

Ex.2:  dadas suas características, o Carro Cherry foi classificado pelo modelo como tendo 85% de chance (propensão) de ser da categoria D.

Alguns algoritmos que fazem isso:
  • Regressão logística - binária
  • Redes Neurais - múltiplas categorias
  • Árvores de decisão - múltiplas categorias

Modelos de Estimação


São modelos que buscam predizer uma variável contínua. Modelos assim estimam o valor de uma variável quantitativa. É um aprendizado supervisionado.

Exemplos: valor de vendas; valor de um imóvel; peso de uma pessoa.

Ex.1: dadas suas características, o valor do imóvel 1 é estimado em R$293.908.

Ex.2: dadas suas características, o peso de Maria é estimado em 65 quilos.

Alguns algoritmos que fazem isso:
  • Regressão Linear
  • Redes Neurais

Modelos de Segmentação


São modelos que buscam encontrar similaridades entre indivíduos/objetos. É um aprendizado não supervisionado.

Exemplos: grupos de pessoas similares; grupos de produtos similares; grupos de cidades similares.

Ex.1: dadas suas características, João, Maria e Paulo foram agrupados como similares no segmento 1; Ana, Cláudia e Mário foram agrupados como similares no segmento 2.

Ex.2: dadas suas características, as cidades de são Paulo, Rio de Janeiro e Porto Alegre foram agrupadas como similares no segmento 1; Natal, Maceió e Fortaleza foram agrupadas como similares no segmento 2.

Alguns algoritmos que fazem isso: 
  • K-means
  • Two-step

Modelos de Regras de Associação


São modelos que buscam encontrar padrões de ocorrência de eventos/fatos. É um aprendizado não supervisionado.

Exemplos: produtos que vendem juntos num carrinho de compras; situações que acontecem juntas;

Ex.1: dadas as ocorrências, em 86% das vezes que uma pessoa coloca macarrão em seu carrinho de compras, ela coloca também frango;

Ex.2: dadas as ocorrências, em 79% das vezes que ocorre uma falha numa rede X de computadores, falta também fornecimento de água no local.


Alguns algoritmos que fazem isso:
  • Apriori
  • Carma


Repare que alguns algoritmos podem ser usados tanto para respostas binárias quanto para respostas de múltiplas categorias e ainda respostas contínuas, como, por exemplo, Redes Neurais.


Abraços miningnoobs!

segunda-feira, 20 de janeiro de 2014

Tipos de aprendizado e variáveis

No contexto de Data Mining, os campos de uma base de dados são chamados de variáveis. Ex.: idade, sexo, estado civil etc. Cada variável representa um tipo de informação que descreve alguma característica de algo ou alguém.
É através destas variáveis que os modelos buscam fazer suas previsões e descobertas. Mais que isso, algumas dessas variáveis são justamente o alvo da previsão.

Conforme já comentamos em outro post, DM nada mais é do que o processo de aprendizagem pelo qual um algoritmo passa, e é importante sabermos que existem dois tipos de aprendizado artificial:


Tipos de aprendizado


  • Aprendizado supervisionado


No aprendizado supervisionado existem dois tipos de papéis que uma variável pode representar.
Temos a variável resposta, ou seja, um alvo que desejamos prever, classificar ou estimar. E temos as variáveis explicativas, que são as variáveis que possibilitam prever/classificar/estimar a variável resposta.

Exemplos: prever se vai ou não chover dadas as variáveis climáticas; classificar a classe social de uma pessoa dadas suas características; estimar o valor de um imóvel dadas suas características etc.

Neste tipo de aprendizado, temos um conjunto de variáveis (características) diversas que explicam o por quê de uma determinada resposta (categoria ou valor).

Exemplo
Um imóvel pode ter:
- seu valor estimado em R$100.000 (variável resposta)
- porque fica na zona leste; tem 3 quartos; fica a 800 metros do metrô; é pintado de azul (variáveis explicativas)

Variável resposta - variável alvo da previsão/classificação/estimação
Variáveis explicativas - variáveis que explicam (preveem/classificam/estimam) e definem o valor da variável resposta


  • Aprendizado não supervisionado


No aprendizado não supervisionado, não temos uma variável resposta. O papel de todas as variáveis é igual. Elas representam fatores ou eventos.
Desta forma, tentamos encontrar similaridades ou padrões entre os dados.

Exemplo: agrupar pessoas dadas suas características; encontrar padrões em carrinhos de compras de super mercados.


Tipos de variáveis

Tanto para variável resposta, variável explicativa ou fator, temos dois tipos de medição de variável:

Variáveis Quantitativas – valores numéricos que representam contagens. Ex.: salário, idade, peso etc.
Variáveis Qualitativas – valores que representam categorias. Ex.: estado civil, sexo, classe social etc.


Para cada tipo de variável podemos aplicar diferentes tipos de modelos (algoritmos), supervisionado ou não, dependendo da pergunta que queremos responder.


Abraços miningnoobs!

sexta-feira, 17 de janeiro de 2014

Data Mining vs BI

BI, ou Business Intelligence significa Inteligência de Negócios, e é uma área da tecnologia da informação (TI) que já existe há um bom tempo e vem sendo utilizada por muitas empresas.

É claro que pode BI também pode ser aplicado fora do mundo dos negócios, seja na medicina, na educação, nas pesquisas acadêmicas ou em qualquer outra coisa.
Isso porque na prática, BI não está focado na conclusão em si, mas nas informações necessárias para chegar a essa conclusão.
Talvez fizesse mais sentido chamar de Business Information (Informações de Negócios).

Então BI dispõe de técnicas e ferramentas como: modelagens especiais de bancos de dados; ferramentas especiais de tratamento de dados; ferramentas especiais de visualização de dados.
Tudo isso para prover um conjunto de informações que sejam relevantes para algum usuário que têm interesse em analisar o assunto em questão (referente a esses dados).
Afinal de contas, os dados dos sistemas transacionais (sistemas da ponta, como por exemplo de uma loja de eletro domésticos) não costumam ficar facilmente acessíveis, integrados e organizados para que os tomadores de decisão possam visualizar seus conteúdos. Então BI está ai para resolver este problema. Ou seja, juntar dados de diferentes fontes, padronizar estes dados, limpar as "sujeiras" de cadastros, formatar os dados de um modo que faça sentido para o negócio e por fim apresentar isso de um modo visual inteligível e inteligente.

Agora, por mais legal que o BI seja, ele nos mostra apenas o passado. Ou seja, a partir dele podemos ver os históricos dos acontecimentos de um modo organizado que faça sentido.
Mas e o futuro?

É nesse ponto que podemos complementar nosso BI com Data Mining. Isso porque conforme vimos em um post anterior, através das técnicas de DM podemos fazer previsões e ainda identificar padrões complexos nos dados; coisa que no BI seria improvável, pois dependeria de um algoritmo mental  muito complicado, que em geral as pessoas não tem em muitas situações.

É claro que muitas vezes o feeling (ou o Blink, como diria o Malcolm Gladwell... ^^) funciona bem, mas quando se trata de muito dinheiro em jogo, ou da vida e saúde das pessoas, acho que é mais recomendável tomar as decisões com o maior respaldo possível!

As informações extraídas e partir dos modelos de DM podem ser, além de aplicadas em sistemas transacionais, carregadas em ferramentas de BI para ajudar na tomada de decisão tática e estratégica.

Uma analogia que a IBM costuma usar é a do retrovisor e o GPS. O retrovisor é o BI, pois mostra por onde já fomos, e o GPS é o DM, pois mostra onde devemos ir.


Abraços miningnoobs!


quarta-feira, 8 de janeiro de 2014

Metodologia de modelagem

Para qualquer projeto de data mining, seja lá qual for a área de aplicação, natureza dos dados, ou técnica aplicada, é essencial seguir alguns passos básicos que buscam garantir que um modelo com qualidade mínima seja criado ao final do mesmo.

Uma das metolodogias existes para seguir estes passos é a CRISP-DM (Cross Industry Standard Process for Data Mining).


Esta é composta por 6 etapas:


1 - Entendimento do negócio

Nesta fase buscamos compreender os detalhes sobre a área de atuação com a qual vamos lidar.
Precisamos definir: O que queremos responder ou descobrir com nosso estudo? Qual o público alvo que queremos analisar (objeto de estudo)? Quais são as características, restrições e regras do assunto que estamos analisando? Quais são os recursos que temos disponíveis? E por fim, qual o nosso objetivo final e conceito de sucesso?

2 - Entendimento dos dados

Para realizarmos o processo de modelagem, precisamos ter uma ou mais bases de dados. Precisamos entender o que elas contém, ou seja, quais dados estão disponíveis nas mesmas, o que cada dado significa e como eles se relacionam.
Infelizmente, no mundo real nem sempre existe uma documentação organizada dos significados das variáveis (metadados). Ex.: um campo na base que se chama "nr_slo", pode significar "salário" de uma pessoa, e precisamos descobrir isso, seja consultando documentos ou perguntando para alguém.
Além disso, como as informações costumam estar separadas em diferentes bancos de dados, precisamos achar um meio de juntar esses dados. Para isso, precisamos descobrir quais são as chaves de junção dessas bases (identificadores únicos de registros de dados) e quais as regras de relacionamento entre elas (Modelo de entidade e relacionamento).
Isso sem contar que precisamos ainda saber do significado de negócio de cada variável. Ex.: variável "proporção de multa de contrato". Que proporção é essa e como isso é calculado? Que tipo de contrato é esse? Mais uma vez temos que buscar algum tipo de documentação ou alguém que nos tire essa dúvida.


3 - Preparação dos dados

Na maioria das vezes os dados não estarão formatados da maneira que precisamos.
O fato dos dados virem de sistemas diferentes pode gerar a necessidade de realizar padronizações em campos. Ex.: em alguns sistemas a variável sexo pode ser representada por 'f'/m' e em um outro por '0/1', e é necessário unificar.
Além disso, você pode desejar sumarizar parte dos dados. Ex.: somar todas as compras de um cliente. Derivações como, por exemplo, calcular a idade a partir da data de nascimento é mais um tipo de preparação clássica de dados.
A parte de preparação dos dados é uma das partes mais exaustivas de todo o processo.


4 - Modelagem

Nesta etapa é onde de fato aplicamos os modelos/algoritmos propriamente ditos.
Fazemos testes e análises com as variáveis, aplicamos possíveis transformações que aumentam o poder preditivo das variáveis e aplicamos os algoritmos.

5 - Avaliação

Após aplicar os algoritmos criando assim nosso(s) modelo(s), precisamos realizar algum tipo de procedimento que garanta a qualidade do modelo resultante. Ou seja, o quanto esse modelo acerta ou reflete a realidade? Podemos confiar neste modelo?
Há várias técnicas para verificar isso e responder a essa pergunta, e precisamos aplicar alguma delas.

6 - Implantação

Após pronto e validado o modelo, já podemos colocá-lo em produção para alcançar nossos objetivos iniciais. Os modelos gerados fornecerão parâmetros para que apliquemos na vida real.
Por exemplo: um modelo de previsão de risco de crédito pode fornecer um conjunto de regras sobre as características que classificam uma pessoa como bom ou mal pagador, e qual a probabilidade associada a isso.


Essas 6 fases devem ser seguidas, mas não necessariamente de forma linear. Muitas vezes será necessário voltar em alguma das fases.


Ciclo de vida

Um detalhe importante é que o modelo desenvolvido tem um tempo de vida. Ele um dia deixará de funcionar, mas não é possível dizer quando. Modelos podem durar 1, 2 ou 3 anos, não podemos dizer ao certo.
Isso acontece porque, como modelos são uma representação da realidade, uma vez que a realidade mude, o modelo já não representa nada de interessante. E no mundo em que vivemos, a realidade muda, seja mais ou menos rápido, dependendo da área de aplicação da qual estamos falando.
Por isso é importante acompanhar a performance do modelo ao longo do tempo depois de implantado. Temos que estar atentos ao momento onde ele vai começar a perder essa performance, ou seja, errar muito.
Quando isso acontecer, teremos que desenvolver um novo modelo, com novos dados coletados (mais atuais), e seguir novamente as etapas da metodologia.


Abraços miningnoobs!